Cerca del 40 % de las respuestas de chatbots sobre elecciones en EE. UU. tenía errores, según Forum AI
Un estudio de Forum AI difundido por AFP halló que casi 40 % de las respuestas de ocho chatbots sobre las legislativas estadounidenses tenía al menos un error factual, aunque la metodología completa no fue divulgada.
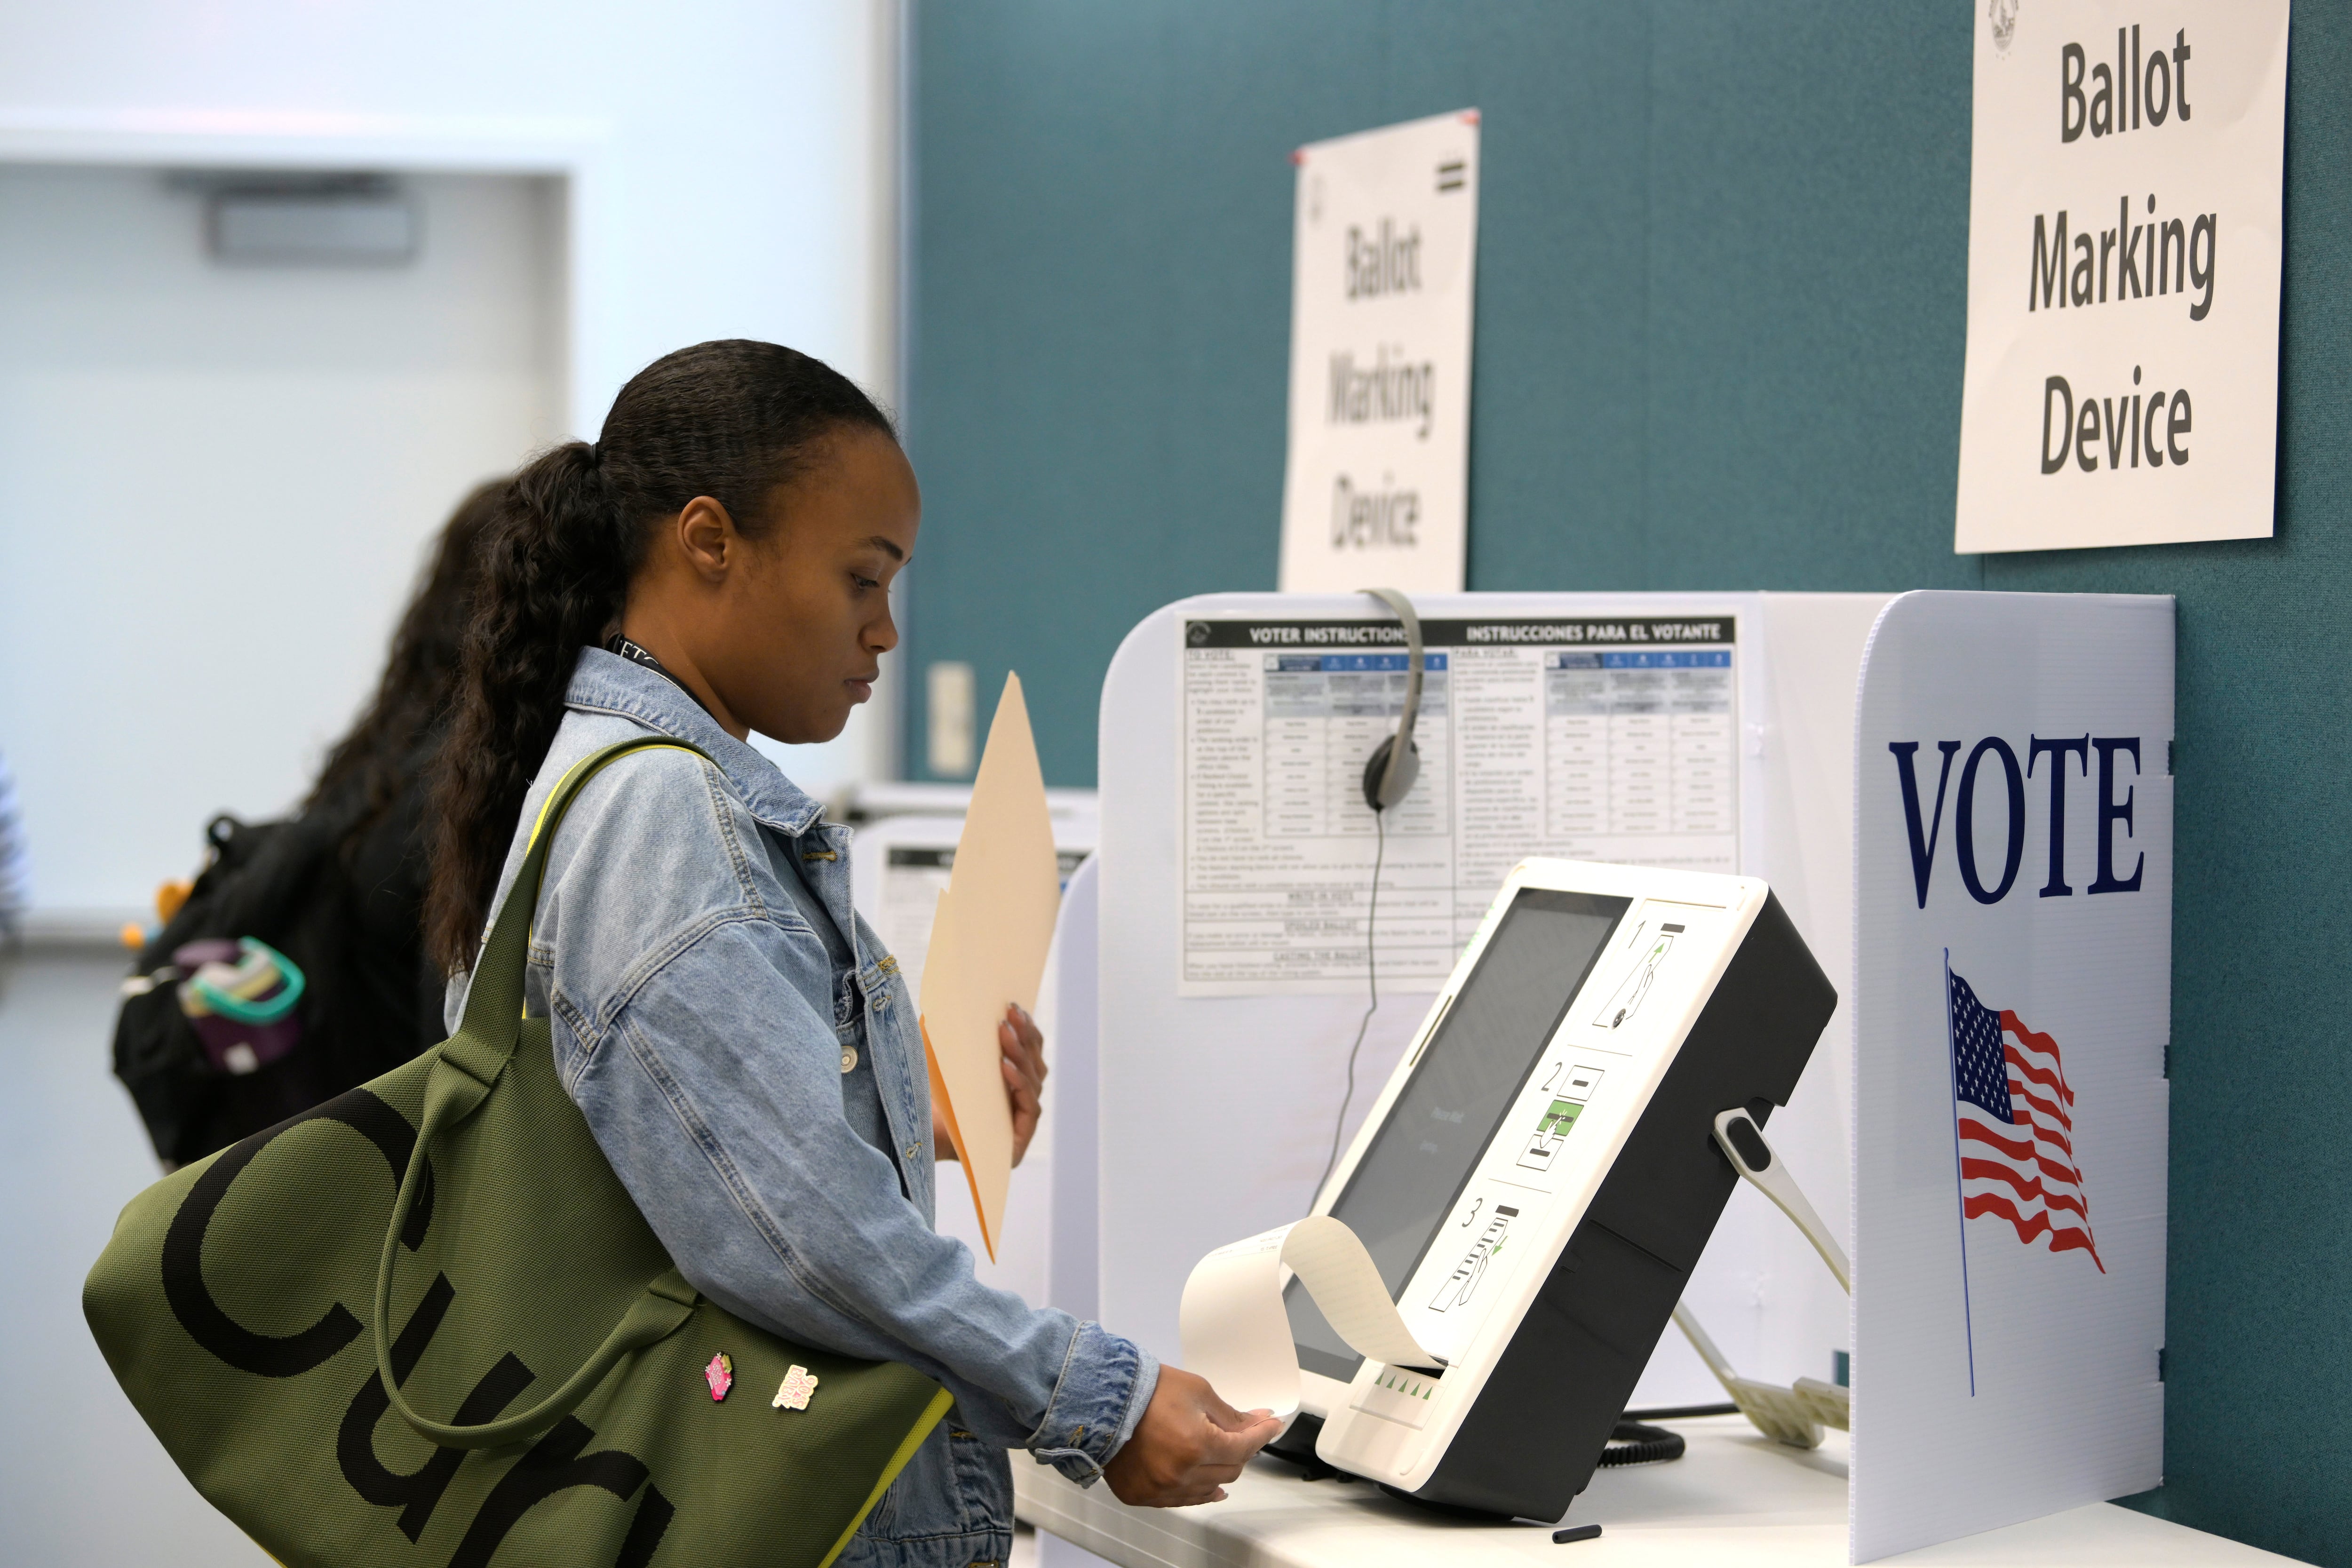
Casi el 40 % de las respuestas que ocho chatbots de inteligencia artificial dieron sobre las elecciones legislativas de Estados Unidos contenía al menos un error factual, según un estudio de la firma evaluadora Forum AI. La agencia AFP lo difundió un día antes de la votación del 3 de noviembre, y lo recoge Infobae. La cifra es un resultado de la propia Forum AI y aún no hay una segunda verificación independiente.
Según AFP, los modelos fallaron más en las preguntas sobre la logística de votar que en las referidas a los candidatos. También atribuyeron declaraciones falsas a candidatos, funcionarios y observadores "cientos de veces" y citaron fuentes de "baja calidad", como hilos de Reddit. AFP no informó cuántas preguntas se hicieron, qué modelos se evaluaron además de los citados ni cómo se puntuaron las respuestas.
Los ejemplos son concretos. Al preguntarle por el plazo para pedir el voto por correo en Pensilvania, Gemini 3.6 Flash, de Google, respondió que vencía el 3 de noviembre, cuando había terminado una semana antes. "Un votante que siguiera la respuesta habría pedido la boleta demasiado tarde para usarla", señaló el estudio. En otra prueba, Claude, de Anthropic, presentó al representante Don Davis como "exsuperintendente escolar", un cargo que corresponde a otra persona. Anthropic no respondió a las consultas de AFP.
Otras mediciones dan cifras mucho más bajas. Según NPR, la organización Innovating for the Public Good probó siete chatbots y encontró un error factual claro en 5,1 % de las respuestas. En las preguntas sobre cómo votar, 13,9 % estaba desactualizado o era inexacto. Anthropic dijo a NPR que, al usarse una interfaz de programación, algunas protecciones de Claude podrían no haber estado activas. La organización respondió que una prueba interna con ambas vías arrojó resultados similares. Microsoft afirmó que mejoró cómo Copilot responde sobre elecciones.
En mayo, Forum AI ya había analizado más de 3.100 preguntas a ChatGPT, Gemini, Claude y Grok. Según Bloomberg, cerca del 36 % de las respuestas tenía un error factual, y Grok fue el peor, con casi 52 %. Ese informe también halló sesgos políticos y que, en 35 % de las respuestas sobre política exterior, los chatbots citaron medios controlados por Estados. Su directora, Campbell Brown, dijo que las empresas "califican su propia tarea" y que hace falta evaluación externa.
El tema importa por el uso creciente de estas herramientas: según una encuesta citada por AFP, dos de cada cinco estadounidenses ya buscaron información electoral con IA, pero solo 40 % confía en ellas para saber cuándo, dónde y cómo votar. La lección sirve para cualquier lector: los datos de trámites y fechas conviene confirmarlos en las autoridades oficiales.
Esta nota se redactó con apoyo de inteligencia artificial a partir de las fuentes citadas y fue revisada y aprobada por la redacción de Ajá Guajira.
Fuentes
- Infobae TecnoFuente primaria
Historial de la noticia
- 6 de nov, 4:41 p. m.Publicada como ◉En verificación
¿Qué te pareció?
Comentarios
Inicia sesión para comentarTambién te puede interesar
 ◉En verificaciónJugadores de GTA VI en Xbox denuncian suspensiones de dos días por clips subidos automáticamentehace 22 horas
 ◉En verificaciónMusk elogia a Anthropic y dice que cortaría el acuerdo de cómputo si causa un daño graveayer
 ✓ConfirmadoCairncross deja la ciberseguridad de la Casa Blanca tras una serie de fallos tecnológicos en EE. UU.anteayer
 ◉En verificaciónJPMorgan, Visa y Mastercard reconocen ciberataque a proveedores que expuso datos de contacto de clienteshace 3 días
Sé el primero en comentar.